
参考图1:男角色
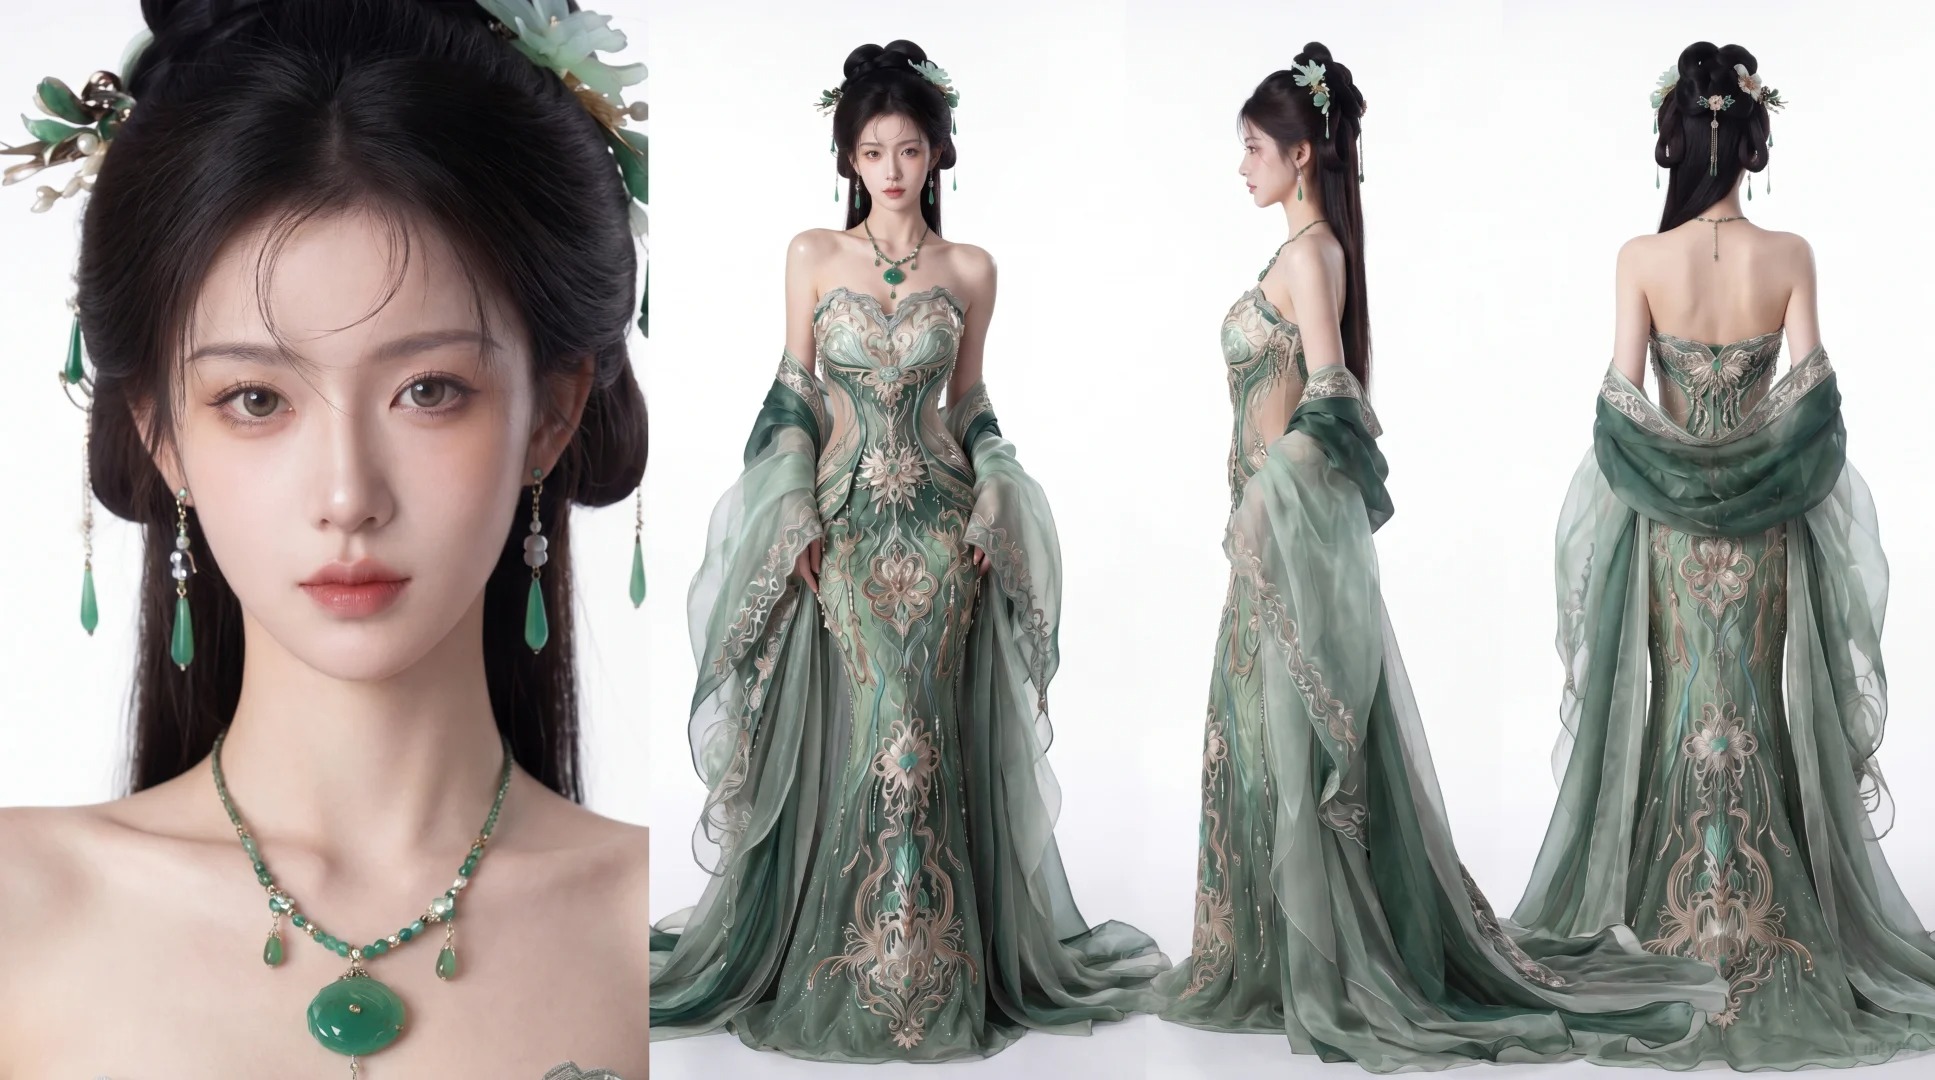
参考图2:女角色
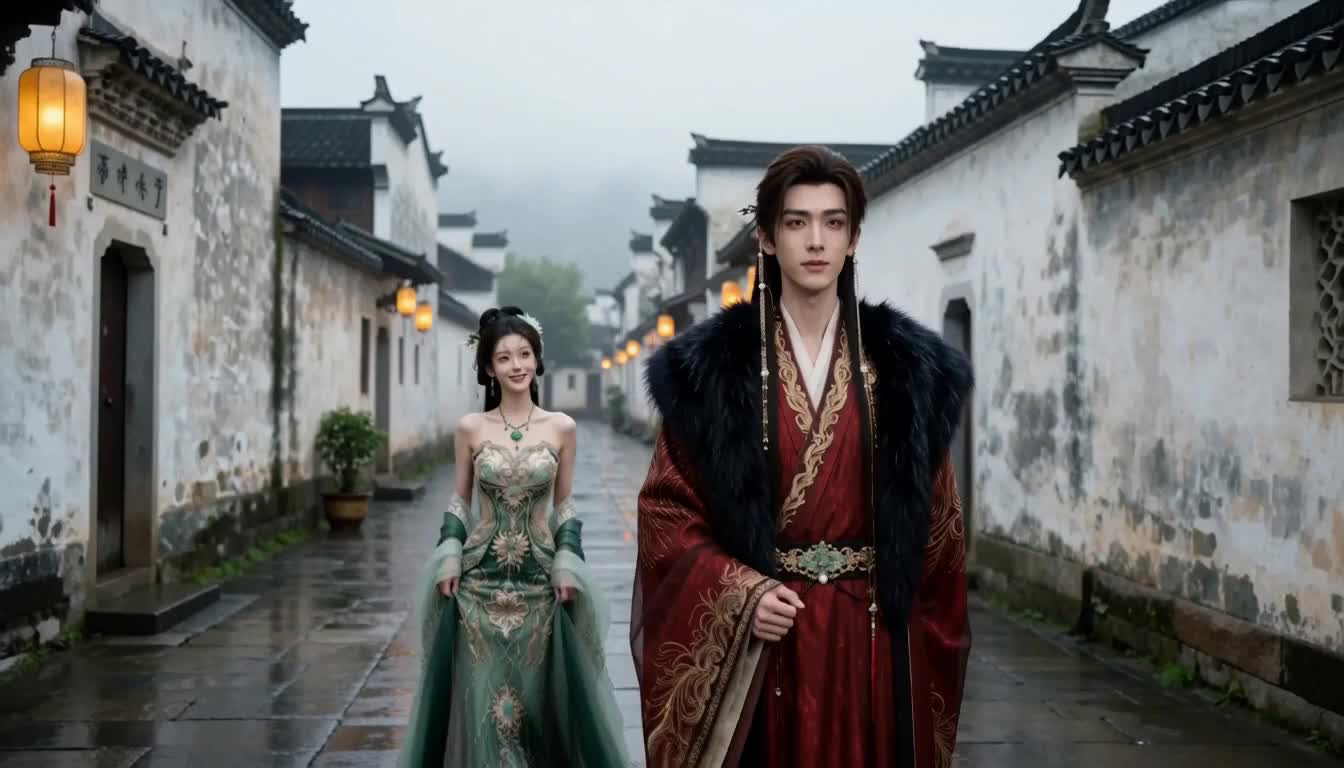
H3 生成第1帧
| 参数 | 值 | 说明 |
|---|---|---|
| 模式 | ref2va (MiniMaxH3ReferenceToVideo) | 参考图条件生成 |
| 参考图 | 3张 (2角色+1场景) | ref_image_size=match |
| 分辨率 | 1344×768 (16:9) | H3 adapt_canvas 标准横屏 |
| 帧数 | 141 (n%17==5) | ~5.875s @24fps |
| 采样 | 15步 · euler · cfg=1.0 | CFG-distilled |
| SigmaShift | shift_video=12.0, shift_audio=3.0 | 官方推荐 |
| 耗时 | ~14分钟 | 含1分钟模型初始化 + 13分48秒采样 |
| 每步耗时 | ~56秒/步 | 3090 int8 (模型缓存后) |
| 维度 | 结果 | 评价 |
|---|---|---|
| 场景还原 | ✓ 江南水乡石板路,白墙黑瓦,远山朦胧 | 场景参考图3很好地还原了氛围 |
| 角色一致性 | ⚠️ 第1帧无人,中间帧出现人物但细节模糊 | 参考图与prompt不匹配(参考图是现代装扮,prompt写古风),H3以prompt为准 |
| 画面动态 | ⚠️ 帧间差异仅 1.93,像素变化 3.8% | 画面偏静,运动量小(dolly-in 效果微弱) |
| 音频质量 | ✓ RMS -14dB,立体声,峰值329Hz | 比之前实验(-18~-57dB)显著好。低频丰富(79.9x),疑似环境氛围音 |
| 尾帧质量 | ✗ 最后一帧噪点/损坏 | VP9编码问题,不影响主体内容 |
| 速度 | ⚠️ 14分钟/6s视频 | 3090 int8,56s/step。比LTX(30s/step)慢约2x |
1. 音频生成:H3 ref2va 的 VAEDecodeAudio 成功提取了立体声音频,RMS -14dB(目前所有实验中最好的一次)。低频功率是高频的 79.9 倍,峰值 329Hz——类似环境氛围音。
2. 场景 vs 角色:H3 很好地还原了场景参考图(江南水乡),但角色一致性取决于参考图与 prompt 的匹配度。本次参考图实际是现代装扮,与 prompt 描述的古风不符。
3. 运动量偏低:帧间差异仅 1.93(之前 S3_3 实验为 5.5-9.1)。dolly-in 效果不明显,画面偏静。
4. 速度:模型缓存后(第二次运行)初始化仅需 1 分钟,每步稳定 ~56 秒。141 帧 15 步总计 14 分钟。
5. 多参考支持:3 张参考图通过 autogrow API(ref_image_0/1/2)成功注入,工作流正常。